
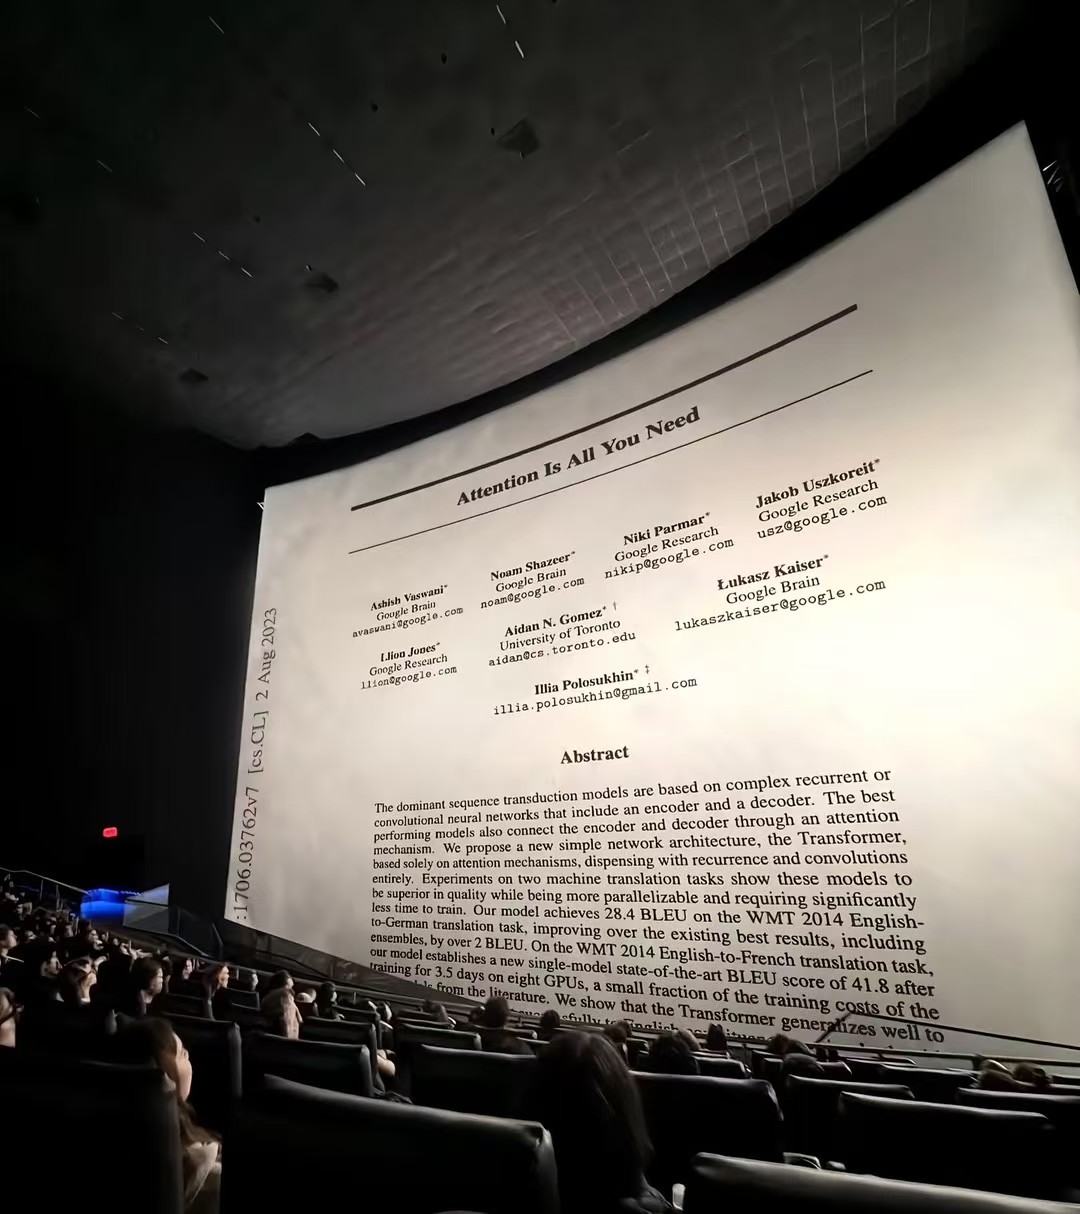
2017年に『Attention Is All You Need』という論文が横空に発表され,その後の数年間,現在に至るまで,生成AIの分野全体を制圧している.この画期的で画期的な論文で,8人の研究者がTransformerというニューラルネットワークのアーキテクチャを初めて提案した.これは,従来の回転と積立操作を放棄して,完全に注意力メカニズムに基づいている.
Transformerは金融の量化に応用される
Transformerの核心的な革新は,自己注意力メカニズム ((Self-Attention) である.これは,配列の任意の2つの要素の間の依存関係を,それらの間の距離がどれほど遠くであっても捉えることができる.この特性は,複雑な時間依存関係を持つ金融時間配列データを処理するのに特に適している.
タイムシーエンスの予測
伝統的な金融タイムシーケンスの予測方法 (ARIMA,LSTMなど) は長期的依存関係を捉えにくく,Transformerはその点で優れている.
多因子モデル
トランスフォーマーでは,数百の因子を同時に処理し,因子間の複雑な非線形関係と時変化特性を自動的に学習できます.
-
要素重要性分析:注意重みによる重要な原動因の識別
-
動的因子暴露:因子の有効性を捉える時の変化の特徴
リスク管理
市場リスクモデル:
-
VaR (リスク・価値) 予測: 極端な市場条件下における非線形的関係に対処する
-
波動率予測:波動率の集積効果とレバレッジ効果を捉える
-
関連性予測:動的資産関連性モデリング
ポートフォリオの最適化
トランスフォーマーには
-
多資産 多周波数データ
-
市場状況の認識と予測
注目重みによる資産選択
トランザクション実行の最適化:
-
市場ショックモデリング:大取引が市場に影響を及ぼす予測
-
取引コストを最小限に抑える最適執行戦略
高周波取引と市場の微細構造
制限価格の注文簿の分析
Transformerは,高周波の注文簿データを効率的に処理できます.
-
オーダーフロー予測: 買い物・販売注文の不均衡を予測する
-
価格衝撃分析:大量の注文が市場価格に与える影響を評価する
-
流動性予測:市場の深さの変化を予測する
市場操作の検知
取引のシーケンスパターンを分析し,以下を特定しました.
-
スプーフィング
-
パンプ・アンド・ダンプ
-
他の市場操作行為
実戦
Transformerは,5次元OHLCV時序データ ((開場価格,最高価格,最低価格,閉場価格,取引量) を処理する.
-
入力形:(batch_size, seq_len=30, feature_dim=5) について
-
シーケンス内の時間依存関係を学習することで,より豊かな時間順の特性を抽出する
-
単純な技術指標よりも複雑な市場パターンを捉える
トランスフォーマーモデル定義 (TimeSeriesTransformerクラス)
class TimeSeriesTransformer(nn.Module):
def __init__(self, input_dim=5, d_model=32, nhead=4, num_encoder_layers=2, dim_feedforward=64, dropout=0.1, num_classes=3):
super(TimeSeriesTransformer, self).__init__()
self.input_proj = nn.Linear(input_dim, d_model)
encoder_layer = nn.TransformerEncoderLayer(d_model, nhead, dim_feedforward, dropout, batch_first=True)
self.transformer_encoder = nn.TransformerEncoder(encoder_layer, num_encoder_layers)
self.feature_layer = nn.Linear(d_model, d_model) # 用于提取特征
self.classifier = nn.Linear(d_model, num_classes) # 用于Transformer自身的预测(如果需要)
def forward(self, src, return_features=False):
src = self.input_proj(src)
memory = self.transformer_encoder(src)
# 取序列的最后一个时间步的输出作为特征
features = self.feature_layer(memory[:, -1, :])
if return_features:
return features
else:
return self.classifier(features)
データプリ処理関数
Transformerのインプットを取得する (scaler)
            def get_transformer_input(klines, index):
    if index < config.TRANSFORMER_SEQ_LEN - 1:
        return torch.zeros(1, config.TRANSFORMER_SEQ_LEN, 5)

    # 提取序列数据
    start_idx = index - config.TRANSFORMER_SEQ_LEN + 1
    end_idx = index + 1
    seq_data = klines[start_idx:end_idx]

    # 转换为OHLCV数组
    ohlcv = np.array([[k["open"], k["high"], k["low"], k["close"], k["volume"]]
                     for k in seq_data])

    # 自动创建并拟合scaler(仅在训练时)
    if ModelRegistry.transformer_scaler is None:
        ModelRegistry.transformer_scaler = StandardScaler()
        if len(klines) > config.TRANSFORMER_SEQ_LEN:
            all_ohlcv = np.array([[k["open"], k["high"], k["low"], k["close"], k["volume"]]
                                 for k in klines])
            ModelRegistry.transformer_scaler.fit(all_ohlcv)

    # 标准化数据
    normalized_ohlcv = ModelRegistry.transformer_scaler.transform(ohlcv)
    return torch.tensor(normalized_ohlcv, dtype=torch.float32).unsqueeze(0)
Transformerの入力を取得する (固定スケーラー)
            def get_transformer_input_with_fixed_scaler(klines, index, fixed_scaler):
    """使用固定的scaler生成Transformer输入(用于实时预测)"""

    seq_data = klines[start_idx:end_idx]
    ohlcv = np.array([[k["open"], k["high"], k["low"], k["close"], k["volume"]]
                     for k in seq_data])

    normalized_ohlcv = fixed_scaler.transform(ohlcv)
    return torch.tensor(normalized_ohlcv, dtype=torch.float32).unsqueeze(0)
トランスフォーマーに関するコード
            if config.TRANSFORMER_ENABLED:
    Log("开始联合训练Transformer和分类器...")

    # 创建Transformer模型
    ModelRegistry.transformer_model = TimeSeriesTransformer(
        input_dim=5,
        d_model=config.TRANSFORMER_D_MODEL,
        nhead=config.TRANSFORMER_NHEAD,
        num_encoder_layers=config.TRANSFORMER_NUM_LAYERS,
        num_classes=3
    )

    # 优化器和损失函数
    optimizer_transformer = torch.optim.Adam(
        ModelRegistry.transformer_model.parameters(),
        lr=config.TRANSFORMER_LEARNING_RATE
    )
    criterion_transformer = nn.CrossEntropyLoss()

    # 准备Transformer训练数据(避免数据泄露)
    X_transformer_sequences = []
    y_transformer_sequences = []

    for i in range(len(klines_for_transformer_training) - config.PREDICT_HORIZON - config.TRANSFORMER_SEQ_LEN + 1):
        # 提取序列
        seq_start = i
        seq_end = i + config.TRANSFORMER_SEQ_LEN
        seq_ohlcv = np.array([[k["open"], k["high"], k["low"], k["close"], k["volume"]]
                            for k in klines_for_transformer_training[seq_start:seq_end]])

        # 标准化
        seq_normalized = ModelRegistry.transformer_scaler.transform(seq_ohlcv)
        X_transformer_sequences.append(seq_normalized)

        # 计算标签(价格变化)
        current_kline = klines_for_transformer_training[seq_end - 1]
        future_kline = klines_for_transformer_training[seq_end - 1 + config.PREDICT_HORIZON]
        # ... 标签计算逻辑 ...

    # 训练Transformer模型
    for epoch in range(config.TRANSFORMER_TRAIN_EPOCHS):
        ModelRegistry.transformer_model.train()
        optimizer_transformer.zero_grad()
        outputs = ModelRegistry.transformer_model(X_transformer_sequences)
        loss = criterion_transformer(outputs, y_transformer_sequences)
        loss.backward()
        optimizer_transformer.step()
リアルタイムで予測されるトランスフォーマーコード
            model_expects_transformer = any("transformer_feat" in name for name in ModelRegistry.feature_names)

if model_expects_transformer:
    if config.TRANSFORMER_ENABLED and ModelRegistry.transformer_model and ModelRegistry.transformer_scaler:
        # 检查数据是否足够
        if len(FeatureStore.klines_1min) >= config.TRANSFORMER_SEQ_LEN:
            # 使用固定scaler获取输入
            transformer_input = get_transformer_input_with_fixed_scaler(
                FeatureStore.klines_1min,
                len(FeatureStore.klines_1min) - 1,
                ModelRegistry.transformer_scaler  # 使用训练好的scaler
            )

            # 提取Transformer特征
            with torch.no_grad():
                transformer_feature_np = ModelRegistry.transformer_model(
                    transformer_input,
                    return_features=True
                ).squeeze(0).numpy()
        else:
            # 数据不足时使用零填充
            transformer_feature_np = np.zeros(config.TRANSFORMER_D_MODEL)
    else:
        # 配置禁用或模型丢失时使用零填充
        transformer_feature_np = np.zeros(config.TRANSFORMER_D_MODEL)

# 特征拼接
if transformer_feature_np is not None:
    transformer_cols = [f"transformer_feat_{i}" for i in range(config.TRANSFORMER_D_MODEL)]
    transformer_df = pd.DataFrame(transformer_feature_np.reshape(1, -1), columns=transformer_cols)

    # 合并表格特征和Transformer特征
    final_features_for_model_df = pd.concat([scaled_features_df, transformer_df], axis=1)
モデル保存とロード
トランスフォーマーモデルを保存:
            if config.TRANSFORMER_ENABLED and ModelRegistry.transformer_model:
    transformer_path = os.path.join(config.MODEL_DIR, f"transformer_model_{version}.pth")
    torch.save(ModelRegistry.transformer_model.state_dict(), transformer_path)

    # 同时保存scaler
    transformer_scaler_path = os.path.join(config.MODEL_DIR, f"transformer_scaler_{version}.pkl")
    with open(transformer_scaler_path, 'wb') as f:
        pickle.dump(ModelRegistry.transformer_scaler, f)
トランスフォーマーモデルをダウンロードする
            if config.TRANSFORMER_ENABLED:
    transformer_path = os.path.join(config.MODEL_DIR, f"transformer_model_{ModelRegistry.current_model_version}.pth")

    if os.path.exists(transformer_path):
        ModelRegistry.transformer_model = TimeSeriesTransformer(
            input_dim=5,
            d_model=config.TRANSFORMER_D_MODEL,
            nhead=config.TRANSFORMER_NHEAD,
            num_encoder_layers=config.TRANSFORMER_NUM_LAYERS,
            num_classes=3
        )
        ModelRegistry.transformer_model.load_state_dict(torch.load(transformer_path))
        ModelRegistry.transformer_model.eval()

        # 加载scaler
        transformer_scaler_path = os.path.join(config.MODEL_DIR, f"transformer_scaler_{ModelRegistry.current_model_version}.pkl")
        with open(transformer_scaler_path, "rb") as f:
            ModelRegistry.transformer_scaler = pickle.load(f)
設定するパラメータ
            self.TRANSFORMER_ENABLED = self.config["transformer"]["enabled"]  # 是否启用
self.TRANSFORMER_SEQ_LEN = self.config["transformer"]["seq_len"]  # 序列长度(30)
self.TRANSFORMER_D_MODEL = self.config["transformer"]["d_model"]  # 特征维度(32)
self.TRANSFORMER_NHEAD = self.config["transformer"]["nhead"]      # 注意力头数(4)
self.TRANSFORMER_NUM_LAYERS = self.config["transformer"]["num_layers"]  # 层数(2)
self.TRANSFORMER_TRAIN_EPOCHS = self.config["transformer"]["train_epochs"]  # 训练轮数
self.TRANSFORMER_LEARNING_RATE = self.config["transformer"]["learning_rate"]  # 学习率
特徴名管理
            def update_feature_names_with_transformer():
    """更新特征名称列表以包含Transformer特征"""
    base_features = [...]  # 29个基础特征

    if config.TRANSFORMER_ENABLED:
        transformer_features = [f"transformer_feat_{i}" for i in range(config.TRANSFORMER_D_MODEL)]
        ModelRegistry.feature_names = base_features + transformer_features
    else:
        ModelRegistry.feature_names = base_features  # 仅29个特征
トランスフォーマー ワークフロー
            实时预测时:
1. 获取最近30根K线的OHLCV数据 → (30, 5)
2. 使用训练时确定的scaler标准化 → 标准化后的(30, 5)
3. 输入Transformer模型 → 提取32维特征向量
4. 与29维表格特征拼接 → 61维特征向量
5. 输入LightGBM进行最终预测
6. 输出:上涨/下跌/盘整的概率分布
要約する
トランスフォーマーモデルは,金融分野に革命的な変化をもたらし,その強力なシーケンスモデリング能力は,金融時間シーケンス分析に特に適しています. 取引の量化からリスク管理,代替データ分析からポートフォリオの最適化まで,トランスフォーマーは,金融技術のあらゆる分野をリフォームしています.
しかし,Transformerを成功に活用するには,データの不安定性,シグナルのノイズ性,規制の複雑性などの金融市場の特殊性を深く理解する必要があります.将来的には,モデル説明性の向上,計算効率の最適化,金融分野専用のアーキテクチャの発展により,Transformerは金融分野においてより大きな価値をもたらすことが期待されています.


- 1