
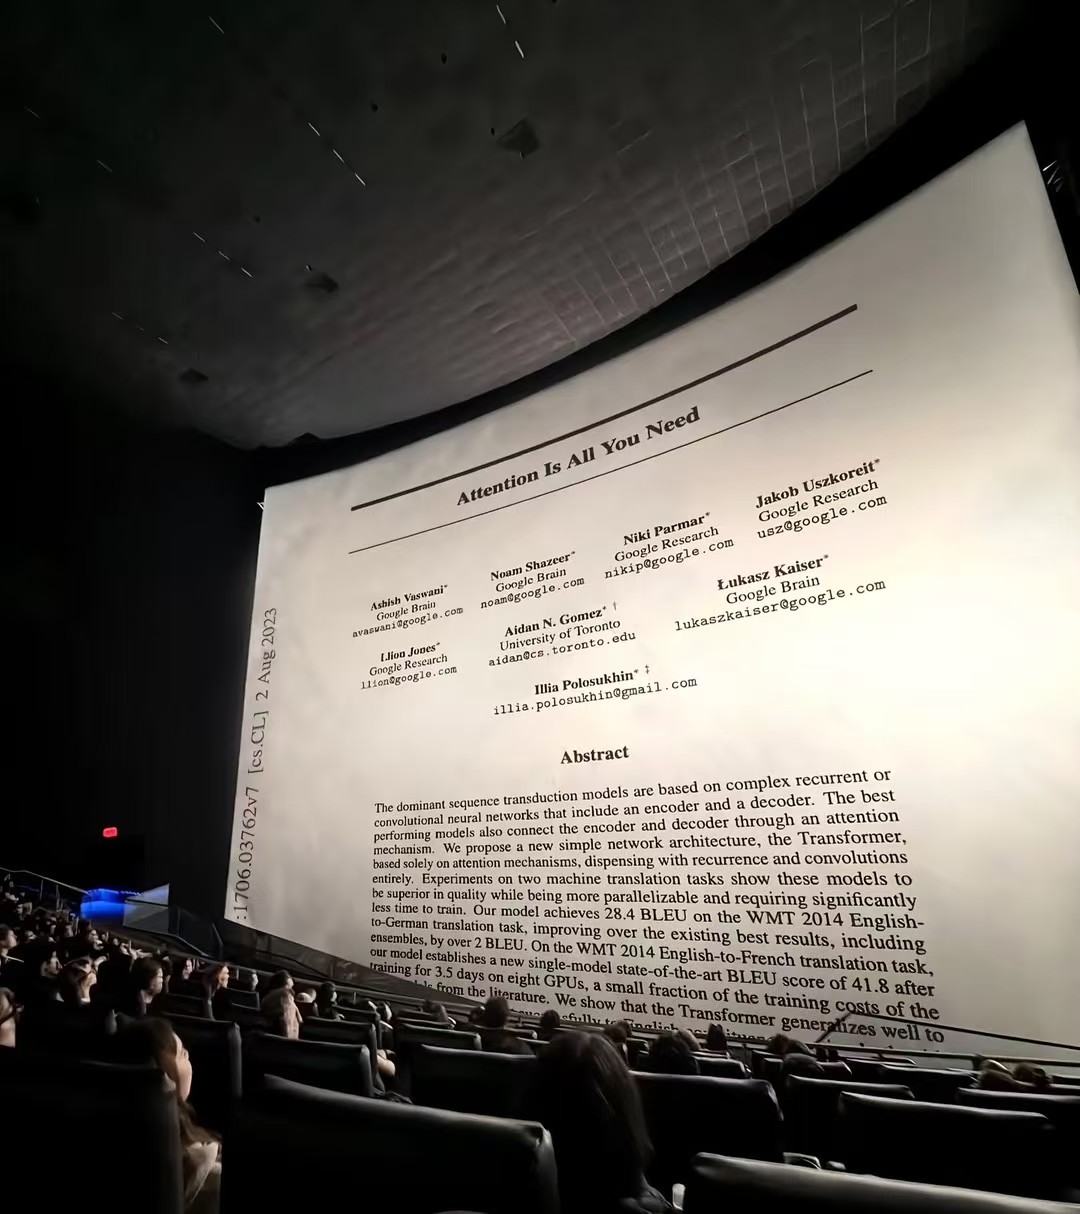
Năm 2017, một bài báo có tên Attention Is All You Need đã được công bố, và trong vài năm sau đó, nó đã phá vỡ toàn bộ lĩnh vực AI tạo ra. Trong bài báo mang tính bước ngoặt và đột phá này, 8 học giả nghiên cứu lần đầu tiên đưa ra kiến trúc mạng thần kinh của Transformer, độc đáo là nó hoàn toàn dựa trên cơ chế chú ý, từ bỏ các hoạt động vòng lặp và cuộn truyền thống.
Transformer ứng dụng cho định lượng tài chính
Sự đổi mới cốt lõi của Transformer là cơ chế tự chú ý (Self-Attention), nó có thể nắm bắt mối quan hệ phụ thuộc giữa bất kỳ hai yếu tố nào trong chuỗi, bất kể khoảng cách giữa chúng. Tính năng này làm cho nó đặc biệt phù hợp để xử lý dữ liệu chuỗi thời gian tài chính có mối quan hệ phụ thuộc thời gian phức tạp.
Dự đoán chuỗi thời gian
Các phương pháp dự đoán chuỗi thời gian tài chính truyền thống (như ARIMA, LSTM) khó nắm bắt các mối quan hệ phụ thuộc dài hạn, trong khi Transformer làm tốt trong lĩnh vực này.
Mô hình đa yếu tố
Transformer có thể xử lý hàng trăm yếu tố cùng một lúc, tự động học các mối quan hệ phi tuyến tính phức tạp giữa các yếu tố và tính năng thay đổi thời gian
-
Phân tích sự quan trọng của yếu tố: Xác định các yếu tố thúc đẩy quan trọng thông qua trọng lượng chú ý
-
Tiếp xúc với các yếu tố động: đặc điểm thay đổi theo thời gian để nắm bắt hiệu quả của các yếu tố
Quản lý rủi ro
Mô hình hóa rủi ro thị trường:
-
VaR (giá trị rủi ro) dự báo: xử lý các mối quan hệ phi tuyến tính trong điều kiện thị trường cực đoan
-
Dự báo tỷ lệ dao động: nắm bắt hiệu ứng tập trung và hiệu ứng đòn bẩy của tỷ lệ dao động
-
Dự báo liên quan: Mô hình liên quan của tài sản động
Tối ưu hóa danh mục đầu tư
Transformer có thể xử lý:
-
Dữ liệu đa tài sản, đa tần số
-
Nhận biết và dự đoán tình trạng thị trường
Lựa chọn tài sản dựa trên trọng lượng chú ý
Tối ưu hóa giao dịch:
-
Mô hình hóa cú sốc thị trường: dự đoán ảnh hưởng của giao dịch lớn đến thị trường
-
Chiến lược thực hiện tối ưu: giảm thiểu chi phí giao dịch
Giao dịch tần số cao và cấu trúc thị trường
Phân tích sổ sách đơn đặt hàng giá giới hạn
Transformer có thể xử lý dữ liệu sổ đơn hàng tần số cao một cách hiệu quả:
-
Dự báo dòng đơn đặt hàng: dự báo sự mất cân bằng của các đơn đặt hàng mua bán
-
Phân tích tác động giá: đánh giá ảnh hưởng của đơn đặt hàng lớn đến giá thị trường
-
Dự báo thanh khoản: dự báo sự thay đổi độ sâu của thị trường
Phát hiện thao túng thị trường
Phân tích mô hình chuỗi giao dịch, nhận diện:
-
Hành vi giả mạo
-
Mô hình Pump and Dump
-
Các hành vi thao túng thị trường khác
Chiến tranh thực tế
Transformer chuyên xử lý dữ liệu theo thứ tự 5 chiều OHLCV ((giá mở, giá cao nhất, giá thấp nhất, giá đóng, khối lượng giao dịch):
-
Hình thức nhập: batch_size, seq_len=30, feature_dim=5
-
Lấy các đặc điểm thời gian phong phú hơn bằng cách học các mối quan hệ phụ thuộc thời gian trong chuỗi
-
Các chỉ số kỹ thuật đơn giản có thể nắm bắt được các mô hình thị trường phức tạp hơn
Định nghĩa mô hình Transformer (lớp TimeSeriesTransformer)
class TimeSeriesTransformer(nn.Module):
def __init__(self, input_dim=5, d_model=32, nhead=4, num_encoder_layers=2, dim_feedforward=64, dropout=0.1, num_classes=3):
super(TimeSeriesTransformer, self).__init__()
self.input_proj = nn.Linear(input_dim, d_model)
encoder_layer = nn.TransformerEncoderLayer(d_model, nhead, dim_feedforward, dropout, batch_first=True)
self.transformer_encoder = nn.TransformerEncoder(encoder_layer, num_encoder_layers)
self.feature_layer = nn.Linear(d_model, d_model) # 用于提取特征
self.classifier = nn.Linear(d_model, num_classes) # 用于Transformer自身的预测(如果需要)
def forward(self, src, return_features=False):
src = self.input_proj(src)
memory = self.transformer_encoder(src)
# 取序列的最后一个时间步的输出作为特征
features = self.feature_layer(memory[:, -1, :])
if return_features:
return features
else:
return self.classifier(features)
Chức năng xử lý trước dữ liệu
Nhận đầu vào của Transformer (scaler)
            def get_transformer_input(klines, index):
    if index < config.TRANSFORMER_SEQ_LEN - 1:
        return torch.zeros(1, config.TRANSFORMER_SEQ_LEN, 5)

    # 提取序列数据
    start_idx = index - config.TRANSFORMER_SEQ_LEN + 1
    end_idx = index + 1
    seq_data = klines[start_idx:end_idx]

    # 转换为OHLCV数组
    ohlcv = np.array([[k["open"], k["high"], k["low"], k["close"], k["volume"]]
                     for k in seq_data])

    # 自动创建并拟合scaler(仅在训练时)
    if ModelRegistry.transformer_scaler is None:
        ModelRegistry.transformer_scaler = StandardScaler()
        if len(klines) > config.TRANSFORMER_SEQ_LEN:
            all_ohlcv = np.array([[k["open"], k["high"], k["low"], k["close"], k["volume"]]
                                 for k in klines])
            ModelRegistry.transformer_scaler.fit(all_ohlcv)

    # 标准化数据
    normalized_ohlcv = ModelRegistry.transformer_scaler.transform(ohlcv)
    return torch.tensor(normalized_ohlcv, dtype=torch.float32).unsqueeze(0)
Nhận đầu vào của Transformer (scaler cố định)
            def get_transformer_input_with_fixed_scaler(klines, index, fixed_scaler):
    """使用固定的scaler生成Transformer输入(用于实时预测)"""

    seq_data = klines[start_idx:end_idx]
    ohlcv = np.array([[k["open"], k["high"], k["low"], k["close"], k["volume"]]
                     for k in seq_data])

    normalized_ohlcv = fixed_scaler.transform(ohlcv)
    return torch.tensor(normalized_ohlcv, dtype=torch.float32).unsqueeze(0)
Mã liên quan đến Transformer trong khóa đào tạo
            if config.TRANSFORMER_ENABLED:
    Log("开始联合训练Transformer和分类器...")

    # 创建Transformer模型
    ModelRegistry.transformer_model = TimeSeriesTransformer(
        input_dim=5,
        d_model=config.TRANSFORMER_D_MODEL,
        nhead=config.TRANSFORMER_NHEAD,
        num_encoder_layers=config.TRANSFORMER_NUM_LAYERS,
        num_classes=3
    )

    # 优化器和损失函数
    optimizer_transformer = torch.optim.Adam(
        ModelRegistry.transformer_model.parameters(),
        lr=config.TRANSFORMER_LEARNING_RATE
    )
    criterion_transformer = nn.CrossEntropyLoss()

    # 准备Transformer训练数据(避免数据泄露)
    X_transformer_sequences = []
    y_transformer_sequences = []

    for i in range(len(klines_for_transformer_training) - config.PREDICT_HORIZON - config.TRANSFORMER_SEQ_LEN + 1):
        # 提取序列
        seq_start = i
        seq_end = i + config.TRANSFORMER_SEQ_LEN
        seq_ohlcv = np.array([[k["open"], k["high"], k["low"], k["close"], k["volume"]]
                            for k in klines_for_transformer_training[seq_start:seq_end]])

        # 标准化
        seq_normalized = ModelRegistry.transformer_scaler.transform(seq_ohlcv)
        X_transformer_sequences.append(seq_normalized)

        # 计算标签(价格变化)
        current_kline = klines_for_transformer_training[seq_end - 1]
        future_kline = klines_for_transformer_training[seq_end - 1 + config.PREDICT_HORIZON]
        # ... 标签计算逻辑 ...

    # 训练Transformer模型
    for epoch in range(config.TRANSFORMER_TRAIN_EPOCHS):
        ModelRegistry.transformer_model.train()
        optimizer_transformer.zero_grad()
        outputs = ModelRegistry.transformer_model(X_transformer_sequences)
        loss = criterion_transformer(outputs, y_transformer_sequences)
        loss.backward()
        optimizer_transformer.step()
Mã Transformer trong dự đoán thời gian thực
            model_expects_transformer = any("transformer_feat" in name for name in ModelRegistry.feature_names)

if model_expects_transformer:
    if config.TRANSFORMER_ENABLED and ModelRegistry.transformer_model and ModelRegistry.transformer_scaler:
        # 检查数据是否足够
        if len(FeatureStore.klines_1min) >= config.TRANSFORMER_SEQ_LEN:
            # 使用固定scaler获取输入
            transformer_input = get_transformer_input_with_fixed_scaler(
                FeatureStore.klines_1min,
                len(FeatureStore.klines_1min) - 1,
                ModelRegistry.transformer_scaler  # 使用训练好的scaler
            )

            # 提取Transformer特征
            with torch.no_grad():
                transformer_feature_np = ModelRegistry.transformer_model(
                    transformer_input,
                    return_features=True
                ).squeeze(0).numpy()
        else:
            # 数据不足时使用零填充
            transformer_feature_np = np.zeros(config.TRANSFORMER_D_MODEL)
    else:
        # 配置禁用或模型丢失时使用零填充
        transformer_feature_np = np.zeros(config.TRANSFORMER_D_MODEL)

# 特征拼接
if transformer_feature_np is not None:
    transformer_cols = [f"transformer_feat_{i}" for i in range(config.TRANSFORMER_D_MODEL)]
    transformer_df = pd.DataFrame(transformer_feature_np.reshape(1, -1), columns=transformer_cols)

    # 合并表格特征和Transformer特征
    final_features_for_model_df = pd.concat([scaled_features_df, transformer_df], axis=1)
Lưu và tải mô hình
Lưu mô hình Transformer:
            if config.TRANSFORMER_ENABLED and ModelRegistry.transformer_model:
    transformer_path = os.path.join(config.MODEL_DIR, f"transformer_model_{version}.pth")
    torch.save(ModelRegistry.transformer_model.state_dict(), transformer_path)

    # 同时保存scaler
    transformer_scaler_path = os.path.join(config.MODEL_DIR, f"transformer_scaler_{version}.pkl")
    with open(transformer_scaler_path, 'wb') as f:
        pickle.dump(ModelRegistry.transformer_scaler, f)
Tải mô hình Transformer:
            if config.TRANSFORMER_ENABLED:
    transformer_path = os.path.join(config.MODEL_DIR, f"transformer_model_{ModelRegistry.current_model_version}.pth")

    if os.path.exists(transformer_path):
        ModelRegistry.transformer_model = TimeSeriesTransformer(
            input_dim=5,
            d_model=config.TRANSFORMER_D_MODEL,
            nhead=config.TRANSFORMER_NHEAD,
            num_encoder_layers=config.TRANSFORMER_NUM_LAYERS,
            num_classes=3
        )
        ModelRegistry.transformer_model.load_state_dict(torch.load(transformer_path))
        ModelRegistry.transformer_model.eval()

        # 加载scaler
        transformer_scaler_path = os.path.join(config.MODEL_DIR, f"transformer_scaler_{ModelRegistry.current_model_version}.pkl")
        with open(transformer_scaler_path, "rb") as f:
            ModelRegistry.transformer_scaler = pickle.load(f)
Các tham số cấu hình
            self.TRANSFORMER_ENABLED = self.config["transformer"]["enabled"]  # 是否启用
self.TRANSFORMER_SEQ_LEN = self.config["transformer"]["seq_len"]  # 序列长度(30)
self.TRANSFORMER_D_MODEL = self.config["transformer"]["d_model"]  # 特征维度(32)
self.TRANSFORMER_NHEAD = self.config["transformer"]["nhead"]      # 注意力头数(4)
self.TRANSFORMER_NUM_LAYERS = self.config["transformer"]["num_layers"]  # 层数(2)
self.TRANSFORMER_TRAIN_EPOCHS = self.config["transformer"]["train_epochs"]  # 训练轮数
self.TRANSFORMER_LEARNING_RATE = self.config["transformer"]["learning_rate"]  # 学习率
Quản lý tên đặc trưng
            def update_feature_names_with_transformer():
    """更新特征名称列表以包含Transformer特征"""
    base_features = [...]  # 29个基础特征

    if config.TRANSFORMER_ENABLED:
        transformer_features = [f"transformer_feat_{i}" for i in range(config.TRANSFORMER_D_MODEL)]
        ModelRegistry.feature_names = base_features + transformer_features
    else:
        ModelRegistry.feature_names = base_features  # 仅29个特征
Transformer Workflow
            实时预测时:
1. 获取最近30根K线的OHLCV数据 → (30, 5)
2. 使用训练时确定的scaler标准化 → 标准化后的(30, 5)
3. 输入Transformer模型 → 提取32维特征向量
4. 与29维表格特征拼接 → 61维特征向量
5. 输入LightGBM进行最终预测
6. 输出:上涨/下跌/盘整的概率分布
Tóm tắt
Mô hình Transformer mang lại những thay đổi mang tính cách mạng cho lĩnh vực tài chính, khả năng mô hình chuỗi mạnh mẽ của nó đặc biệt phù hợp với phân tích chuỗi thời gian tài chính. Từ định lượng giao dịch đến quản lý rủi ro, từ phân tích dữ liệu thay thế đến tối ưu hóa danh mục đầu tư, Transformer đang định hình lại các lĩnh vực của công nghệ tài chính.
Tuy nhiên, để ứng dụng thành công Transformer cần hiểu sâu về các đặc điểm của thị trường tài chính, bao gồm tính không ổn định của dữ liệu, sự ồn ào của tín hiệu và sự phức tạp của quy định. Trong tương lai, Transformer có thể có giá trị lớn hơn trong lĩnh vực tài chính với sự cải thiện khả năng giải thích mô hình, tối ưu hóa hiệu quả tính toán và phát triển các cấu trúc chuyên dụng trong lĩnh vực tài chính.


- 1